
O diagnóstico do capítulo 4 mostrou como as IAs falam da Lumora. Mostrou também um detalhe que passa despercebido: o site da própria marca é só a terceira fonte mais citada, atrás do Reclame Aqui e do Mercado Livre. Antes de escrever uma linha nova, vale uma pergunta mais básica: as IAs conseguem ler o que já está lá?
Este é o capítulo técnico do guia, escrito para quem não é técnico. Ele mostra quem visita o site em nome das IAs, como abrir ou fechar a porta para cada um, o que impede uma página de ser lida e como saber, pelos números, se o site está sendo usado nas respostas. Muitas correções são simples. O difícil é descobrir que elas são necessárias.
Os robôs que leem o seu site
Um robô (ou crawler) é um programa que visita páginas e guarda o que leu. O Google usa robôs há décadas para montar a busca, e as empresas de IA também têm os seus. Cada um se apresenta com um nome, o user agent, que fica anotado no registro de visitas do servidor.
Os robôs das IAs fazem dois trabalhos diferentes:
- Coletar para treinar. Leem a web em grande volume para formar o conhecimento dos próximos modelos. O que leem hoje pode influenciar o que a IA sabe de memória daqui a meses, mas não vira link em nenhuma resposta.
- Buscar para responder. Visitam páginas para que a IA possa encontrá-las e citá-las quando alguém pergunta. É deles que dependem as respostas com fontes.
Algumas empresas separam esses trabalhos em robôs com nomes diferentes. Os exemplos mais conhecidos:
- OpenAI: o
GPTBotcoleta para treinar os modelos; oOAI-SearchBotencontra as páginas que aparecem nas respostas com pesquisa do ChatGPT. Há ainda oChatGPT-User, para as visitas feitas quando alguém, no meio da conversa, pede ao ChatGPT que abra uma página. - Anthropic: o
ClaudeBotcoleta conteúdo que pode ser usado no treino dos modelos Claude. A Anthropic documenta outros robôs para busca e para visitas a pedido de quem conversa. - Perplexity: o
PerplexityBotencontra as páginas que o Perplexity mostra e cita nas respostas. - Google: o
Google-Extendednão é um robô, e sim um nome que o Google lê no robots.txt para saber se o conteúdo que já coleta pode ser usado nos modelos Gemini. Bloqueá-lo não tira o site da busca, mas, pela documentação do Google, pode reduzir o uso do site nas respostas do Gemini, que é uma das IAs que você mede. O AI Overviews e o AI Mode fazem parte da busca e dependem do robô de sempre, oGooglebot.
A lista muda com o tempo. Antes de mexer em qualquer regra, confira o nome exato na página que cada empresa mantém sobre os próprios robôs.
O robots.txt: um pedido na porta
O robots.txt é um arquivo de texto simples que fica sempre no mesmo endereço, na raiz do site: lumora.com.br/robots.txt. Qualquer pessoa pode abri-lo no navegador. Ele diz a cada robô, pelo nome, o que pode e o que não pode visitar.
As regras vêm em grupos. Cada grupo começa com User-agent: e o nome do robô, seguido de linhas Disallow: (não visite) ou Allow: (pode visitar) com o caminho. Traduzindo alguns exemplos:
User-agent: GPTBotcomDisallow: /: "robô de treino da OpenAI, não visite nada". A barra sozinha representa o site inteiro.User-agent: OAI-SearchBotcomAllow: /: "robô de busca da OpenAI, pode visitar tudo".User-agent: *: o grupo que vale para todos os robôs sem um grupo com o próprio nome. UmDisallow: /carrinho/ali pede a todos que não visitem as páginas do carrinho.
Dois detalhes pegam muita gente. O robô que encontra um grupo com o próprio nome segue só aquele grupo: se você criar um grupo para o GPTBot, as regras do asterisco deixam de valer para ele. E cada subdomínio tem o próprio arquivo: se a loja fica em loja.lumora.com.br, o robots.txt do site principal não vale para ela.
Liberar ou bloquear é decisão da empresa, e as duas famílias de robôs pedem decisões separadas. Bloquear os de busca tende a tirar o site das respostas com fonte daquela IA. Bloquear só os de treino é uma escolha legítima, com um custo: a IA pode saber menos sobre a marca quando responde de memória. Para quem quer ser recomendado, o caminho sensato é deixar os robôs de busca entrarem e decidir com calma sobre os de treino.
O bloqueio que ninguém pediu
O problema mais comum não é o bloqueio decidido, e sim o que ninguém sabe que existe. Ele pode vir de vários lugares:
- Um robots.txt herdado, copiado de outro site ou de um modelo pronto, que ninguém relê há anos.
- A CDN, o serviço que entrega o site a partir de servidores espalhados pelo mundo. Algumas oferecem uma opção para bloquear robôs de IA, e ela pode estar ligada sem que o marketing saiba, por padrão ou por uma decisão antiga.
- O firewall e as regras de segurança da hospedagem, os filtros que decidem quem acessa o servidor, que às vezes tratam um robô legítimo como ataque.
- Plugins de segurança do WordPress e de outras plataformas, que bloqueiam robôs por listas prontas.
- Limites de visitas, que recusam quem pede muitas páginas seguidas, justamente o que faz o robô que veio ler o catálogo.
O sintoma costuma ser o mesmo: o robô chega e recebe um erro, ou uma tela de verificação, em vez da página, enquanto no navegador está tudo normal. Por isso, a pergunta ao time de tecnologia precisa ser específica: "o robots.txt, a CDN, o firewall, a hospedagem ou algum plugin bloqueiam algum robô de IA? Qual, e por decisão de quem?". A confirmação vem dos registros do servidor, que aparecem mais adiante.
O que não está no HTML, muitos robôs não veem
Toda página chega ao navegador como HTML, o texto com marcações que descreve o que aparece na tela. Em muitos sites, parte do conteúdo não vem nesse HTML: é montada depois, no navegador, por programas em JavaScript. O navegador executa esses programas e mostra a página completa. Muitos robôs de IA não executam: leem o HTML que o servidor entregou e vão embora. O que só aparece depois, para eles, não existe.
O robô do Google executa JavaScript, mas nem todo robô faz o mesmo, e não convém depender disso. O que importa para a marca ser citada precisa estar no HTML desde o início. Os casos mais comuns de conteúdo que fica de fora:
- preço, estoque e ficha técnica carregados por um script da loja virtual;
- avaliações de clientes que vêm de um quadro pronto, fornecido por outra empresa;
- abas e botões de "ver mais" que só buscam o texto quando alguém clica;
- sites montados como aplicativo, em que o HTML inicial chega quase vazio;
- e, sem JavaScript nenhum, texto dentro de imagem, como o banner com as condições de frete.
Dá para testar sem ser técnico. Abra a página, clique com o botão direito e escolha "Exibir código-fonte da página" (no Chrome, Ctrl+U; no Mac, Cmd+Option+U). Essa tela mostra o HTML como o servidor entregou. Procure ali, com Ctrl+F (Cmd+F no Mac), uma frase importante: o preço, a garantia, o nome do produto. Se ela não estiver lá, um robô que não executa JavaScript também não vai encontrá-la. Não use o "Inspecionar" para esse teste: ele mostra a página já montada e esconde o problema.
A solução fica com o time de tecnologia, com nomes conhecidos como renderização no servidor e pré-renderização: as duas entregam a página já montada no HTML. O pedido do marketing é simples: o que importa precisa aparecer no código-fonte.
Uma página fácil de aproveitar
Uma IA raramente usa uma página inteira. Ela pega o trecho que responde à pergunta e, às vezes, cita a página como fonte. A página que facilita esse recorte tem mais chance de ser usada, e o que ajuda a IA é, quase sempre, o que ajuda quem lê com pressa:
- Títulos que dizem o assunto. "Garantia de 2 anos em todas as luminárias" diz muito mais que "Nosso compromisso".
- Uma ideia por seção. Garantia e prazo de entrega no mesmo bloco não respondem bem a nenhuma das duas perguntas.
- A resposta na primeira frase, e o detalhe depois: "A linha Mini foi pensada para ambientes de até 10 m²" e, em seguida, como e por quê.
- Tabela de especificações em cada produto: medidas, potência, tipo de luz, regulagem, área indicada, se é bivolt. Em texto, não em imagem.
- O mesmo nome sempre. Se o produto é "Lumora Pro" numa página, "Pro" em outra e "luminária de piso premium" numa terceira, a IA pode não perceber que é o mesmo.
Dados estruturados: o que ajudam e o que não prometem
Dados estruturados são uma descrição da página escrita para máquinas, colocada no código e invisível para quem lê. Em vez de deixar o robô deduzir que "R$ 349" é um preço, a página declara: isto é um produto, este é o preço, em reais, e ele está disponível. O vocabulário mais usado é o do schema.org, criado pelos grandes buscadores, e o formato mais comum é o JSON-LD, um bloco de código dentro do HTML. Os tipos que mais interessam a uma marca:
- Organization: a empresa, com nome, logotipo, site, contatos e os perfis oficiais em outros sites (no campo
sameAs); - Product: cada produto, com nome, descrição, marca e imagem;
- Offer, dentro do produto: o preço, a moeda (
BRL, para reais) e a disponibilidade; - FAQPage: as perguntas e respostas de uma página de dúvidas.
O que eles ajudam: deixam os fatos sem ambiguidade para quem lê o código, e o Google os usa para entender a página e montar alguns destaques nos resultados. O que não prometem: nenhuma plataforma de IA garante usá-los para decidir o que citar, e a marcação não transforma uma página fraca em fonte. São um reforço do que está escrito, não um atalho.
E precisam dizer o mesmo que a página. Lojas virtuais e plugins costumam gerá-los sozinhos, e é comum um preço antigo ficar preso ali depois de mudar na tela. Quando um fato muda, confira os dois lugares; o Google e o schema.org oferecem validadores gratuitos.
Os fatos, cada um na sua página
O capítulo 2 pediu uma lista de fatos, cada um com a página de origem. Agora é hora de conferir se essas páginas existem, estão atualizadas e podem ser lidas por um robô. Quase toda marca precisa de:
- Preços, na página de cada produto ou numa página própria, em texto e em reais;
- Garantia, trocas e devoluções, com prazos e condições;
- Entrega e frete: regiões atendidas, prazos e a regra do frete grátis;
- Sobre a empresa: o que faz, para quem, desde quando, de onde, e o que não faz;
- Atendimento: canais, horários, WhatsApp e onde a empresa responde a reclamações.
Três cuidados fazem diferença. Ligue essas páginas no menu ou no rodapé, para que os robôs as encontrem. Mostre a data da última atualização. E, quando um fato muda, mude em todos os lugares: a página antiga com o preço velho, o catálogo em PDF e o banner da promoção encerrada continuam competindo com a página nova. Página que saiu do ar deve redirecionar para a nova (o redirecionamento 301, no jargão).
Na revisão da Lumora, dois fatos da lista não estavam em texto em lugar nenhum. O frete grátis acima de R$ 299 só aparecia num banner, em imagem. E o fato de a marca não vender lâmpadas avulsas não constava de página alguma, embora a pergunta apareça no atendimento. A página de entrega passou a trazer a regra do frete em texto, e a página "Sobre" ganhou o que faltava: fundada em 2019, em Curitiba; luminárias para ambientes de até 10 m², com luz de leitura regulável; garantia de 2 anos; entrega em todo o Brasil em até 7 dias úteis; sem lâmpadas avulsas.
Velocidade e erros básicos
Um robô que busca na hora de responder costuma ter pouco tempo, porque há alguém esperando. Uma página lenta ou com erro pode ficar de fora. O básico do SEO técnico cobre quase tudo:
- Páginas rápidas, que não dependem de dezenas de scripts para mostrar o texto, e que não caem em dia de promoção;
- Endereços que funcionam: página removida responde "não encontrada" (o erro 404); página que mudou de endereço leva direto ao novo;
- Um mapa do site atualizado (o arquivo
sitemap.xml), com as páginas que importam; - Nenhuma barreira na frente do conteúdo: verificação de idade, cadastro obrigatório ou texto que só carrega depois de aceitar os cookies deixam o robô sem nada para ler.
O que os registros do servidor contam
Cada visita ao site, de gente ou de robô, deixa uma linha no registro do servidor, o log: data e hora, a página pedida, o nome com que o visitante se apresentou e a resposta que recebeu. Se o site usa CDN, o registro dela também importa: quando a CDN entrega uma cópia guardada da página, a visita nem chega ao servidor da empresa.
Esses registros mostram quais robôs de IA visitam o site, quais páginas leem e se conseguiram ler. Cruzados com as citações do diagnóstico do capítulo 4, separam três situações:
- Visitada e citada. O caminho funciona; o trabalho é manter a página certa e atualizada.
- Visitada e não citada. Primeiro, confira se o robô viu o conteúdo ou só um HTML vazio. Se viu, o problema é o que a página oferece: ela não responde bem às perguntas do tema, ou fontes que a IA considera mais confiáveis dizem o mesmo com mais clareza. A saída está no conteúdo e na reputação fora do site, assunto do capítulo 6.
- Nem visitada. Pode ser bloqueio, página sem nenhum link que leve a ela ou fora do mapa do site. O problema é de porta, e nenhum texto novo resolve enquanto ela estiver fechada.
A Lumora cruzou um mês de registros com as citações. O guia do blog sobre como escolher uma luminária para ler era visitado pelos robôs de busca e aparecia com frequência como fonte. A página da Lumora Pro era visitada, mas quase nunca citada, o que fez sentido depois do teste do código-fonte. E a página de entrega não recebia visita de robô nenhum: só havia link para ela a partir do carrinho, que o robots.txt pede para não visitar, e ela não estava no mapa do site.
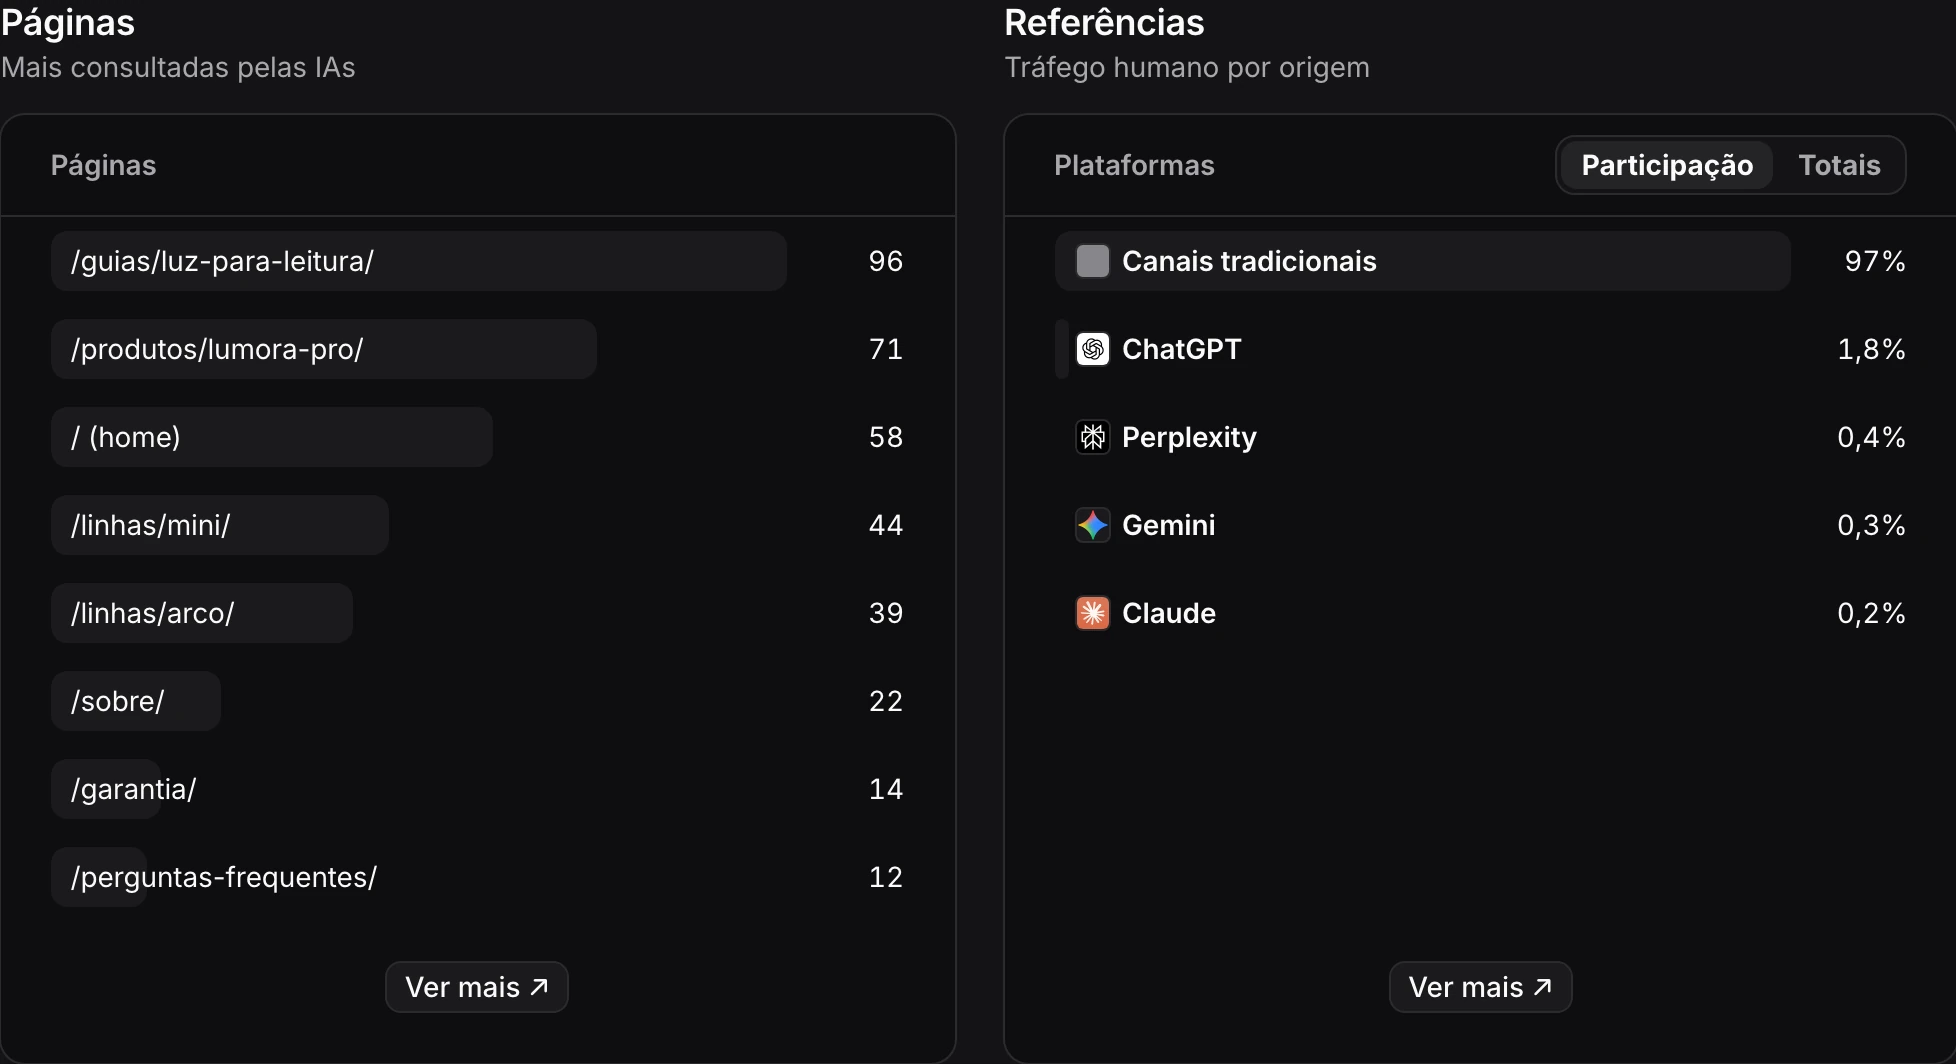
Dois cuidados na leitura. O nome com que o visitante se apresenta pode ser falso: há programas que se dizem ChatGPT para entrar onde não deveriam. As grandes empresas de IA publicam como confirmar que uma visita é delas, em geral com a lista dos endereços IP de onde os robôs saem, e vale saber se a sua ferramenta de registros faz essa conferência. E o endereço IP de quem visita pode ser considerado dado pessoal pela LGPD: guarde os registros com acesso restrito e pelo prazo combinado com o jurídico e com quem cuida de privacidade: o Marco Civil da Internet pede que sites com fins econômicos guardem os registros de acesso por seis meses, e a LGPD pede que não se guarde além do necessário.
As visitas que chegam das IAs
Quando alguém clica num link dentro da resposta de uma IA, a visita chega ao site como qualquer outra. Nas ferramentas de análise, como o Google Analytics, ela costuma aparecer com o endereço de origem: chatgpt.com, perplexity.ai, gemini.google.com, claude.ai. Nem sempre cai como tráfego de referência: conforme a etiqueta do link, pode ficar sem canal definido, e por isso vale o grupo próprio descrito abaixo.
Algumas plataformas ainda acrescentam ao link um parâmetro UTM, uma etiqueta no fim do endereço que diz a origem da visita. O ChatGPT, por exemplo, costuma marcar os links com utm_source=chatgpt.com. Isso ajuda a reconhecer a visita mesmo quando a informação de origem se perde no caminho.
Vale criar, na ferramenta de análise, um grupo só para as IAs e acompanhar quantas visitas chegam, em quais páginas entram e o que fazem depois. As páginas de entrada costumam coincidir com as que as IAs citam, e vale comparar as duas listas.
Esse número, porém, conta só uma parte da história:
- A resposta basta, ou o clique vem depois. Como o capítulo 1 mostrou, muitas vezes a pessoa não clica, ou chega depois por outro caminho, e isso aparece como tráfego direto ou busca pela marca.
- A origem se perde. Alguns aplicativos não informam de onde a visita veio, e ela entra como tráfego direto. E os cliques no AI Overviews e no AI Mode costumam chegar como busca orgânica do Google, misturados com os demais.
Por isso, o tráfego vindo das IAs é um sinal útil, não a medida do resultado. A influência inteira se lê junto com a presença nas respostas, a busca pelo nome da marca e o "como você nos conheceu?". O capítulo 7 volta a esse assunto.
Por onde começar
Revisar o site inteiro de uma vez assusta. Uma ordem que funciona, do mais barato para o mais trabalhoso:
- A porta. Leia o robots.txt e pergunte à tecnologia sobre CDN, firewall, hospedagem e plugins. É a correção mais barata e, quando há bloqueio, a mais urgente.
- Os fatos. Cada fato da lista do capítulo 2 numa página, em texto, atualizado e ligado no menu ou no rodapé.
- O código-fonte das páginas principais. Home, produtos, preços, sobre: o que importa está no HTML?
- A estrutura e os dados estruturados dessas mesmas páginas.
- A medição. Os registros dos robôs e as visitas que chegam das IAs, para acompanhar o efeito de tudo isso.
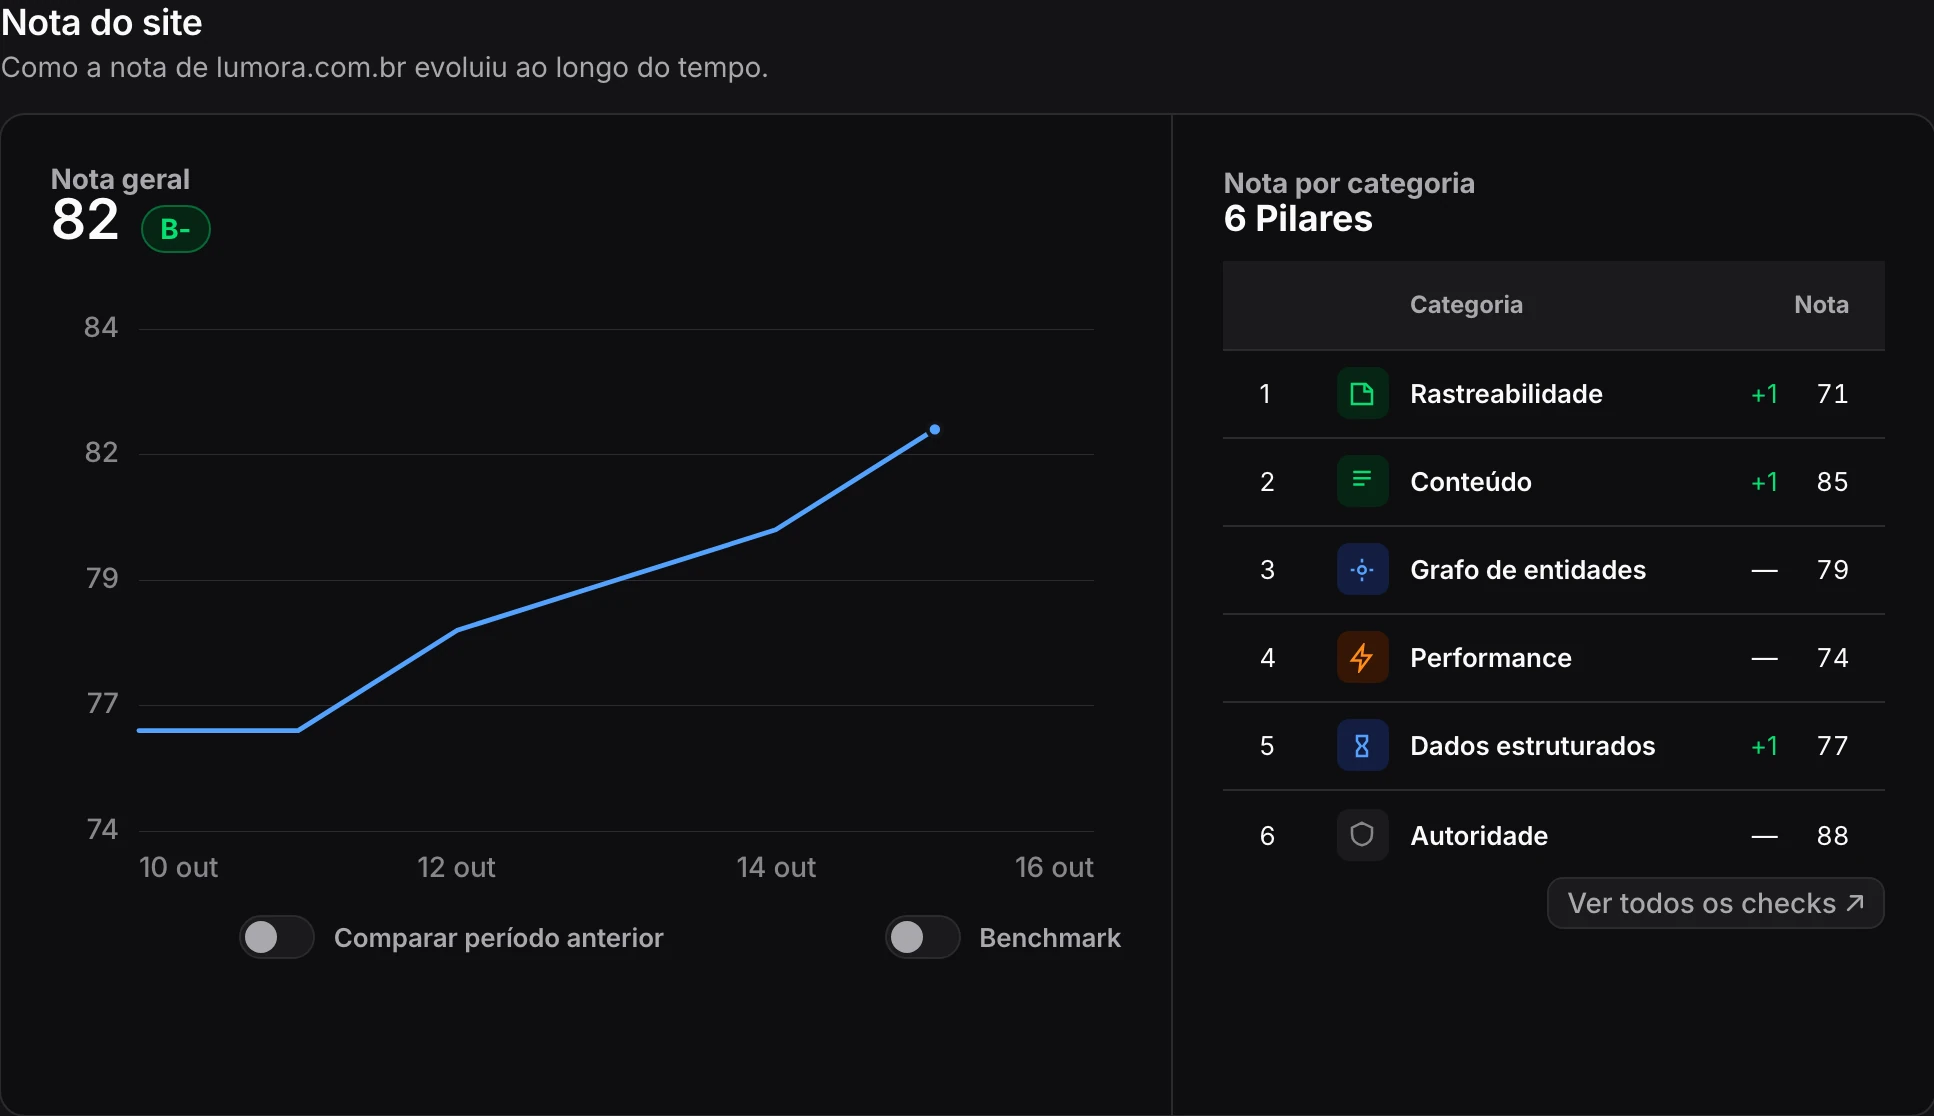
O checklist técnico dos apêndices transforma essa ordem em itens que se conferem um a um. Com a porta aberta e as páginas legíveis, o capítulo 6 trata do que escrever e onde.